INFH5000 · Member 2 研究手册 · 2026-11-18
研究对象 周期性无机晶体、MatterGen 冻结权重、未经弛豫的生成候选。
交付 可解码的晶体结构、去噪轨迹、条件和求解器的配对实验,以及逐样本来源记录。
材料发现要做两件不同的事。给定一个结构,可以估计它的能量或受扰动后的响应;给定一个设计要求,则要提出值得检验的结构。后一项任务有许多可能的解:同一种元素组合容许不同配比,同一个化学式也可以有不同的原子排列。本项目用一个生成模型给出这些候选,并追踪每个候选从随机状态到结构文件的过程。后续的模型预测、第一性原理计算与实验分别可以提供有关性质、稳定性和可实现性的证据。MatterGen 论文 · 项目交接说明(课程仓库,需权限)
阅读路径 第一幕解决“计算机怎样表示和读取晶体”,第二幕解决“设计要求与数据空间决定怎样的生成问题”,第三幕沿一次真实推理考察“怎样生成、怎样干预、怎样检验输出”。页面使用的图、曲线和表格可以通过本手册的证据链接复查。离线交互页面 · 逐候选实验索引
| 记录集 | 统计单位 | 可以回答的问题 |
|---|---|---|
| 无条件基础批次 | 8 个 CUDA 样本;另有 1 个 Apple MPS 样本单列 | 一个完整候选如何生成、导出和交接? |
| 配对采样器 | 原批 3 个初态 × 3 种方法;另有 3 个固定为 8 位点的初态 × 3 种方法,共 18 个终态 | 固定起点时求解器改变什么?固定求解器与后续随机种子时,先验几何怎样影响结果? |
| 化学体系与 CFG | 2 个种子 × 2 个目标 × 7 档引导 = 28 个终态;另有 4 个关闭目标元素筛选的终态 | 模型对元素集合、比例和引导强度分别有什么响应? |
| 空间群条件 | 4 个初态 × 3 个实验分支 = 12 个终态 | 请求一个对称群后,从导出几何能测得哪个群? |
基础运行和补充实验合计保存 71 个生成端点。其中 62 个属于冻结权重的补充对照。多个端点会共享同一个初态或同一个 seed,部分端点的化学式相同。文中按实验分支给分母。张量探针是对一个既有候选的单步网络计算,另行记录。
第一幕 晶体表示与网络
1 计算机怎样表示一块周期性晶体?
从重复结构到三个变量
考虑向三个方向周期延拓的理想晶体。我们选取一个重复单元,记该晶胞内有 个站点。晶格定义如何平移重复单元,基元定义每个重复单元中有哪些元素、位于哪里。一个三维点集仅给出一次摆放的坐标;加上周期晶格以后,才能确定跨晶胞的距离、邻居与整体对称性。当前模型面向小晶胞周期结构;材料的宏观形状、晶粒和缺陷需要各自的表征。官方权重模型卡
写 。 为第 个站点的一基原子序数。 为无量纲的分数坐标。 的三行分别为三个晶格向量,以 Å 为单位。该站点连同全部周期像的笛卡尔位置为
原胞内位置 ,体积 ,每原子体积为 。这三个公式分别决定前端怎样画点、怎样显示尺寸、怎样跨不同站点数比较几何尺度。例如坐标从 0.99 变到 0.01,有可能只沿第一条晶格方向跨过 0.02 个周期。观察跨界动画时应同时查看晶胞;在斜晶胞里,最短实空间距离还需用实际晶格搜索周期像。读写及坐标实现 · 每帧数据约定(课程仓库,需权限)
CIF 和张量怎样对应?
训练数据由 Materials Project 与 Alexandria 筛选得到,base 使用的缓存名为 Alex-MP-20,训练范围为至多 20 个站点的原胞。官方预处理从 CIF 读晶格、站点和元素,取原胞并进行 Niggli 约化,统一部分晶胞基底选择,再将分数坐标取模 1。base 的变换将行向量晶格替换为极分解中的对称因子 ,保持行向量的 Gram 矩阵,因而保留长度、夹角和体积。原胞化、约化可能改换基底及原子顺序。比较同一结构的两个文件时,要连同晶格和周期像一起核对。官方数据读取 · 原始数据处理与逐字段示例 · 训练数据说明
训练和推理可使用同一种 ChemGraph 批表示。设一批有 个晶体、各有 个站点,。站点级数据按第一维拼接,晶体级数据按晶胞堆叠。
| 字段 | 形状、类型和单位 | 含义与边界 |
|---|---|---|
atomic_numbers |
[N],int64 |
干净标签为原子序数;该模型的带噪数据用 101 表示 MASK。模型内部类别,从 0 编号。 |
pos |
[N,3],float32,无量纲 |
分数坐标,沿每个轴以 1 为周期。 |
cell |
[B,3,3],float32,Å |
每个晶胞的三行晶格向量。 |
num_atoms、batch、ptr |
[B]、[N]、[B+1],整数 |
位点数、站点到批内晶体的索引、晶体切片边界。两个晶体有 3 和 2 个站点时,ptr=[0,3,5]。 |
t |
[B],浮点,无量纲 |
每个样本的噪声时刻,网络调用时单独传入,向对应节点广播。 |
| 性质条件 | 晶胞级字符串、整数标识或浮点字段 | 随权重分别解释为元素集合、空间群和带单位的数值目标。 |
| 来源标识 | material_id、candidate_id、seed、版本和哈希 |
前者来自数据来源,后者用于本组实验追踪。推理中只有模型支持且显式传入的条件参与预测。 |
为什么要转成批张量?网络要同时对大量不同站点数的晶体进行查表、邻居聚合与梯度计算。原子数可以不同,只要每条边的两个端点属于同一晶体,聚合就能按 batch 还原到各自单元。生成时没有目标晶体的 CIF。 base 先从内置 ALEX_MP_20 经验分布抽 ,用该形状创建占位字段,随后由三个先验填入初态。 在一条生成轨迹中固定。批数据与入口 · 最小生成配置
把一个实数算回文件中的坐标
以基础批次的 Cu₂Pd 为单位核对例。CIF 中首个 Cu 的分数坐标约 。配合独立最终 EXTXYZ 的晶格行向量 、、 Å,算得 Å,晶胞体积为 39.01445 ų。给定晶格和同一站点,就能往返于两种坐标表示。最终 CIF · 最终 EXTXYZ(课程仓库,需权限)
2 为什么选周期几何图网络,一次前向发生什么?
上述 Cu 和 Pd 在中央晶胞内的直线距离为 4.1330 Å。给 Pd 加晶格平移 ,得到 2.6117 Å 的另一条位移。神经网络若仅比较中央三个点,会漏掉跨边界的局部环境。MatterGen 在当前坐标和晶格上动态构造 周期近邻图,图边对应满足近邻准则的一对周期像,化学成键需要额外判断。把一条边写为 ,它的相对位移为 。同一对站点编号可以因像偏移不同出现多次。实际站点数据(课程仓库,需权限) · 周期图实现
骨干是 GemNet-T 几何消息传递网络。 这里有四种决定预测的操作。
- 建图。 将当前分数坐标变为笛卡尔点,结合晶格搜索周期像。base 截断半径为 7 Å,最大近邻数配置为 50,每个晶格方向最多搜索 5 级周期像。图存
edge_index[2,E]与整数像偏移to_jimages[E,3]。当前几何更新后,下次前向会重新构图。 - 嵌入。 元素及 MASK 经查表得到 512 维节点向量。每个晶胞的 经 256 对正弦、余弦编码成 512 维,向站点广播,与元素向量拼接后投影为节点隐藏态。空间位置通过相对边向量、距离和角度进入消息传递。径向基展开的默认数目为 128,角向基为 7;边方向与三条晶格轴的夹角还提供晶胞几何信息。
- 传递消息。 对共享中心的两条边构造三元组。边长描述“隔多远”,夹角描述“从哪两个方向靠近”。四个交互块更新 512 维边和节点特征,并汇集多层读出。即使两个局部环境的原子种类和若干边长相似,三元组仍可以帮助区分排列方式。
- 读出。 元素头从节点得
[N,101]个干净类别 logits;位置头沿有向边以学到的标量加权单位方向,按站点聚合三维向量,换算到分数坐标分支;晶格头汇集与方向外积 相关的张量,得到对称[B,3,3]输出。后两项的统计含义是带噪状态的去噪信号。官方骨干还返回名为energy的量,但生成器从元素、位置、晶格三项读出构造候选。报告该材料的实际能量、力或应力需要专门的预测器或物理计算。固定模型配置 · GemNet-T 实现 · 去噪输出变换
哪些对称性有意义? 调换站点的存储顺序应只调换站点级预测,对同一晶胞的整体预期保持一致。全体站点加上共同平移,边的相对位移保持不变。对空间作整体正交旋转,边长和夹角不变,沿边单位向量的笛卡尔向量读出随坐标轴旋转,方向外积按二阶张量变换。模型还在规范化的对称晶格表示中工作。近邻筛选的边界、等距排序和浮点归约顺序在数值层面均可能引入微小差异。以下探针给出置换与平移的单样本检查;旋转一项描述网络的几何构造。几何边与输出头 · 张量转换
本地 CPU 实测。 对上述真实 CIF 重走官方预处理,在 t=0.4、探针 seed=17 下加噪,以同一冻结权重分别输入原结构、按 [2,0,1] 重排的结构、全体分数坐标加 再取模 1 的结构。对置换结果按对应站点比较,晶格直接比较。列中数值为所有分量的最大绝对差,单位分别为原始 logits 或训练参数化下的原始网络输出单位。
| 检查 | 元素头 [3,101] |
位置头 [3,3] |
晶格头 [1,3,3] |
|---|---|---|---|
| 重排站点 | 3.05 × 10⁻⁵ | 3.48 × 10⁻⁷ | 7.15 × 10⁻⁷ |
| 平移并周期包裹 | 2.67 × 10⁻⁵ | 1.79 × 10⁻⁶ | 3.19 × 10⁻⁶ |
本例三个输出量级的最大绝对值约为 22.6、0.871 和 1.48;数值偏差远小于对应输出量级。这项检查能验证当前读取、构图与单步前向对两个变换的响应。它只涉及一个带噪输入。复现代码见附录 A,原始文件含实际带噪输入、环境与所有输出。逐张量探针记录
第二幕 生成目标与模型选择
3 给材料模型一个“提示”,我们究竟规定了什么?
文生图中的一句提示可以指定“雪地里一辆红色汽车”,而视角、积雪形状与背景细节仍有多种可能。晶体设计同样留有自由度,条件可以有很明确的数学内容。写 为要求,本项目在给定 后希望从 采出候选;无性质条件时取 。本轮实验从原有站点数分布取 ,按实验设计保持配对。不同条件权重支持不同字段,条件的类型也决定应怎样独立检验输出。
| 要求 | 送入网络的表示 | 仍由模型决定的量 | 可用于核验的观测 |
|---|---|---|---|
| 无条件 base | 噪声时刻与当前晶体;base 的性质嵌入字典为空 | 元素、配比、坐标、晶格 | 源文件能否解码,生成过程中各字段怎样变化 |
| “Mg–O 化学体系” | chemical_system 字符串拆成元素集合,在长度 101 的向量中令 Z=12,8 的位置取 1,经线性层得 512 维条件向量 |
Mg/O 位点数、排列、晶格 | 最终元素集合是否恰等于 {Mg,O},氧位点比例是多少 |
| “第 225 号空间群” | 国际空间群号 1–230 减 1 后索引 的学习表 | 元素、组成、坐标、晶格 | 按指定距离和角度容差从实际几何重新识别的群号 |
| “目标带隙”或“目标体模量” | 对应权重采用训练统计量标准化标量并作正弦余弦编码;体模量权重还先取 | 满足要求的组成与几何 | 用独立性质模型或物理参考计算实得值及误差;本轮只说明这个接口 |
| “恰好 2 Cu、1 Pd” | 晶体结构预测(CSP)可以直接给定全部元素计数与标签 | 位置和晶格 | 已知组成下的结构与几何。官方该入口要求兼容的 CSP 权重与配置 |
化学体系的目标向量按原子序数索引;去噪头的零基 logits 用 索引。程序会转换两者之间的偏移。条件权重在每个交互块入口把该晶胞的条件向量广播给站点,将其与站点隐藏态拼接,经 MLP 和混合层得到残差。训练开始时混合层可以零初始化;最终使用的是已经学到条件响应的官方权重。条件 dropout 使一个条件模型可以在同一带噪输入上给出有条件和无条件输出。第 7 节将用这两个输出定义 CFG。 条件编码源码 · 逐层注入 · 条件权重与 CSP 的实现区别
化学体系入口还有一道直接施加于输出的约束:有条件分支将集合外元素的 logits 加上约 ,同时保留全局支持元素的筛选。因此“目标中两种元素都出现”仍然需要统计,“集合外元素受到抑制”则有代码层面的解释。空间群条件主要通过已学嵌入影响生成,输出坐标没有被强制投影到某组 Wyckoff 位置。两类条件都能在网页上选择,背后的保证不同。官方生成入口 · 禁止元素的 logit 操作 · 条件实验
4 这种任务应该选择什么扩散模型?
先把“生成什么”与“怎样分解生成”作为两个可组合的问题。图像和晶体都有空间结构,但常见图像潜变量的每个分量可以作连续插值;把 Cu 的类别编号与 Pd 的编号先平均,并不会给出一个有物理意义的“中间元素”。文本和元素都是类别,晶体中负责解释一个元素位点的上下文却还包含连续变化的邻居几何。这两点一起决定了 MatterGen 的联合生成形式。潜空间图像扩散 · 离散扩散 · MatterGen
| 例子 | 条件和目标 | 状态与生成分解 | 网络学习和采样时更新的量 |
|---|---|---|---|
| 连续潜空间图像扩散 | 文本等条件;生成与描述相符的图像 | 固定形状的连续潜变量,通常整幅潜变量一起去噪 | 以高斯前向扰动构造目标,可采用噪声或 score 参数化,最后解码为像素 |
| 连续 flow matching | 条件可有可无;采样连续对象 | 预先设计连接基础分布与数据分布的条件路径,状态可以是整个样本 | 回归该路径的速度场,再用 ODE 积分。推理时用 ODE 的模型也可以由 score 训练得到,需查看实际训练目标。Flow Matching |
| AR-DM / AR-FM | 已有 token 或块作为下一块的条件,还可附全局要求 | 外层以 为生成序号,分解为 ;内层用 DM 或 FM 采样该连续块 | 内层去噪或速度估计经过自己的时间 。Li 等采用逐 token diffusion loss,FELLE 采用 token 级 flow matching。外层的顺序与内层噪声时刻各自有定义。AR-DM · AR-FM |
| 一般离散扩散(D3PM) | 可在类别数据上加入条件,生成类别配置 | 用离散转移矩阵破坏标签,转移可允许替换为其他类别或进入吸收态 | 预测干净类别或反向转移分布,由概率核抽样。D3PM |
| 掩码扩散(Masked Diffusion Model,MDM) | 通过其余上下文恢复未知标签 | 离散扩散中特定的前向核将标签换成吸收态 MASK | 用分类分布恢复遮住的站点。扩散语言模型 LLaDA 将这一机制用于词元,其他域也可以使用。MDM · LLaDA |
| MatterGen | 无条件,或给定化学体系、空间群等;生成完整周期晶体候选 | 一次给定站点数。元素在离散类别空间中,位置在三维环面上,规范化晶格为连续对称矩阵;共享时间,整个晶胞联合细化 | 元素采用带吸收态的 D3PM,坐标为 wrapped VE,晶格为带尺度先验的 VP。GemNet-T 看见全部字段,输出元素 logits 和两类几何信号。固定配置 |
从 EDM 的设计空间看,还要逐项给出加噪分布、训练时刻分布、输出参数化与损失权重、推理网格、数值求解器。MatterGen 的两个连续字段具有不同的前向路径;其中位置要处理周期包裹,晶格有随 改变的中心和方差。训练给网络的输出目标是标准差缩放的 score,离散分支另有类别目标。供推理选择的 PC、祖先更新和概率流 Euler 作用于求解环节。这样才能回答一个具体问题:保留相同的已训练网络时,换哪些组件还能解释为一次可比较的干预?EDM · 逐字段设计空间推导
第三幕 从一次真实生成到三类推理干预
5 网络如何从训练数据学到反向更新,再从随机状态生成?
5.1 三条正向路径
设 ,用 表示连续噪声时刻,用 表示离散掩码核的步数。训练随机抽样晶体及 ;当前版本默认对每一晶胞从 均匀采 。给定干净晶体、站点数和时刻后,分别扰动三类字段。离散前向边际取 。多字段扩散模块 · 类别时间与偏移
元素 。 由第 步向下一步时(),尚未遮住的位点以 的概率替换成 MASK,MASK 保持不变。累乘可得经过 步后原标签仍可见的概率 。因此前向的全 MASK 极限易于采样。这个概率是重复采样的边际规律;某个只有八个位点的单次轨迹可以在连续多个记录中有相同的掩码数。反向时先估计 ,再将该净标签分布与离散状态和已知转移核结合,构造上一个类别状态的分布。原子类别和几何在这一步重新发生关联。掩码核 · 类别反向更新
分数坐标 。 前向边际可以写成
幂律 用晶胞尺度随站点数的典型变化调整分数空间噪声。8 位点样本在高噪声端的标准差为 2.5 个周期,实际 prior 采高斯、缩放后取模。反向要估计带噪分布对分数坐标的 score。前向加噪的一次跨界可以对应多个周期像,训练目标按各可能位移的高斯权重求和。固定源码在每个轴取镜像偏移 ,以有限项近似 wrapped-normal score,乘以当下标准差后与位置头做平方误差。晶体 SDE · 周期 score 与损失
晶格 。 令 站点/ų,,令 。对称 VP 过程以 控制噪声率。定义 ,则
对称噪声由成对非对角项构造,保留每个独立分量的标准方差。初始生成晶胞直接从极限分布取样。八个位点时,先验中心的边长约 5.18 Å,分量标准差为 1 Å。因此模型起步时已有与站点数有关的整体尺度,其角度与长度仍可变化。晶格损失把网络输出与负的标准化扰动比较。晶格预设均值、方差与实现 · 连续损失
5.2 什么是训练,什么是本组的推理?
在发布权重的训练配置中,一批晶体经上述扰动后,共享网络看见 与可用条件。三头损失的结构为
连续头在训练时预测“边际标准差 × score”,推理时除以该标准差得到更新所需的 score。元素的 对应 D3PM 反向一步的变分项,加上系数 0.01 的干净标签交叉熵;最后一段到干净类别的重建使用交叉熵,其他步使用真实与模型反向分布之间的 KL。逐字段先在各自样本内聚合,再对晶体批次求平均。元素类别的标签、位置的周期 score 和晶格的标准化扰动提供三种监督。官方 base 配置还记录了 Adam、学习率 和 batch 配置;本组工作从公开 checkpoint 开始,所有下述生成实验只做推理。训练总配置 · 损失聚合与离散监督 · D3PM 损失细节
推理时,网络参数固定,更新的是晶体本身。默认算法可按如下顺序跟踪。
- 从经验分布产生 ,加入请求的条件 ;构造全 MASK 的 、经周期包裹的 与有尺度先验的 。
- 沿 1,000 个噪声级从 到 。默认 PC 在当前噪声级用一次 Langevin corrector 修正 ,随后再读一次网络结果,三个 predictor 联合更新 。位置和晶格 corrector 的 SNR 参数分别为 0.4 和 0.2。两个子更新前各保存一条状态。
- 原生 predictor 同时给出下一步采样状态和均值分支。最后单独导出的
mean作为生成终态;离散分量采用对应后验的最大概率类别。程序将晶格转换为三边长及夹角,以num_atoms切分元素和分数坐标,构造周期 Structure,再写出 EXTXYZ 与 CIF。此时得到可以读入结构工具的候选模型,其合成和稳定性仍有待验证。 - 基础库把每条 2,000 记录的原始轨迹转换为 120 个显示帧与一个独立 final。元素原值 101 在 ASE 的通用元素表中可能写成
Md,本组遵循固定模型的dim=101, offset=1将这类记录画成灰色 MASK;真实元素值与模型编码同时保留在交接包。默认采样配置 · 更新与记录顺序 · 输出解码 · 转换脚本(课程仓库,需权限)
交互实验怎样显示加噪。 第 5 节固定 Cu₂Pd、训练预处理、base 权重的字段配置与 CPU seed 17。对 101 个时刻 分别重设该种子再调用官方 sample_marginal。左图始终画干净张量,右图以相同投影和物理比例画该时刻的带噪张量。单字段按钮仅替换所选字段,因而可以在固定晶胞中观察坐标位移,或在固定分数坐标上观察晶格变形。共同随机数便于看清噪声幅度,图中相邻快照不能解读为逐步模拟一条前向 SDE;第 6 节的反向轨迹则读自一次完整生成。第 4 节矩阵追踪使用同一 的输入,逐项与单步网络探针核对。101 份边际样本与元数据 · 重算快照的脚本(课程仓库,需权限)
5.3 用一条实际轨迹逐行核对
以下数据来自原无条件批次 tk-cuda-seed42。原始索引从 0 开始。显示帧由均匀抽样得到,某次变化的第一条原始记录和观众第一次能在播放中看见它的帧可能不同。F、In、Tm 的数目按真实标签统计。
| 原始记录 | 未定元素的站点 | F / In / Tm | 每原子晶胞体积 (ų) | 观察 |
|---|---|---|---|---|
| 0 | 8 | 0 / 0 / 0 | 10.11 | 站点和晶胞已存在,元素还待揭示 |
| 991 | 2 | 5 / 1 / 0 | 16.41 | 两个位点还可从灰色直接数出 |
| 1690 | 0 | 6 / 1 / 1 | 16.01 | 原始数据中首次全部有元素标签 |
| 1696 | 0 | 6 / 1 / 1 | 18.02 | 120 个显示帧中可以选取的时刻 |
| 1999 | 0 | 6 / 1 / 1 | 19.15 | 最后一条保存的采样前状态 |
| 独立 final | 0 | 6 / 1 / 1 | 19.17 | 可交付 F₆InTm 的 CIF |
同一条记录已经能支持一个具体的过程判断:全部元素揭示以后,晶格仍在更新。生成轨迹的轴是算法步,体积起伏描述晶胞状态的改变。八次 CUDA 基础运行覆盖 3–20 个站点,最终组成依次为 F₆InTm、CoLu₂Pd、N₁₀Sm₄、B₄Ga₂RhRu₉Sc₄、Ca₂Rb₃Te₆Zr、HGaPdRh、Cu₂Pd、CdNaNi₄。八次均生成可读结构,端到端时间中位数约 78 秒。另有独立 MPS 流程预检查。两个设备的同整数 seed 可产生不同结果,比较时用完整实验 ID。原始帧指标 · 独立最终 CIF · 八样本字段与检验状态 · 设备和耗时口径
6 同一去噪器为什么会走出不同轨迹?
6.1 改变的是哪一步?
令连续字段前向的局部随机变化满足 ,。在本例给定站点数时,扩散幅值与时刻及站点数有关。对匹配的连续噪声过程,反向 SDE 沿时间递减方向使用 加随机增量;对应的概率流 ODE 使用 ,其中 估计当前带噪密度的对数梯度。这解释了把随机噪声项直接设零与构造概率流 Euler 有何区别。我们的连续一步为
各字段使用自身的 。位置用 wrapped VE 后取模,晶格在对称表示中使用有非零先验均值的 VP。元素在全部对照中都做 1,000 次 D3PM 后验抽样。 混合路径因此仍具有离散采样随机性。概率流与反向 SDE 的边际一致性定理涉及理想连续 score 等条件;本实验使用有限步、学习到的 score 和离散耦合,考察的是实测单样本轨迹。图像 DDIM 提供连续高斯扩散中更换推理路径的先例;此处实现的具体方法名称为“连续概率流 Euler + D3PM”。概率流推导 · DDIM · 项目求解器源码(课程仓库,需权限)
| 方法 | 连续字段的更新 | 固定条件及可比较对象 |
|---|---|---|
| 默认 PC | 同一噪声级做一次 Langevin 校正,再做祖先预测 | 与下一行相比,多一次校正及一次网络调用 |
| 仅祖先预测 | 采用同一祖先预测器,移除校正器 | 与上一行共同揭示校正器与额外计算的综合影响 |
| 混合概率流 Euler | 位置和晶格用上述 Euler 更新 | 与仅祖先预测有相同的模型调用数与离散类别更新数,可比较两种连续数值规则 |
逐 seed 使用官方 prior 抽取一次完整初态,然后克隆成三份。对每组的元素、晶格、分数坐标和站点数逐值及哈希核对;连续随机种子取 seed+10000,离散 D3PM 独立随机流取 seed+20000。独立类别随机流避免三种方法调用连续随机数次数不同而直接错开类别随机序列。这仍允许类别 logits 随几何分叉。3 个 seed 是三个配对案例,同一数值的基础库 seed 来自另一种随机流约定。计时在 HKUST RTX A6000 GPU 7、batch 1 上进行,排除加载、预热、写 CIF 和绘图,包含逐步记录到 CPU 和同步。执行顺序按 seed 轮换。实验元数据(课程仓库,需权限) · 配置快照(课程仓库,需权限)
6.2 怎样度量“走了多远”?
在每个共同噪声级 更新前取 。先将每个原始站点的相邻分数位移折回 ,再计算
无量纲。取 999 个相邻级的平均值,衡量算法的一步通常移动多少个分数周期。端点比较另按原始站点索引,从真实 prior 到独立最终结构直接算同一个 RMS。每原子体积由 得到。上式按坐标分量折回,斜晶胞中以 Å 度量的最近空间像需要使用晶格度量。另存的最短邻距包含本位点的非零周期像。当前数值路径记录的位移、时刻和成分切换均具有算法语义。按级分析与 CIF 核对(课程仓库,需权限) · 9,000 条逐级记录
6.3 相同预算下,差别在哪里?
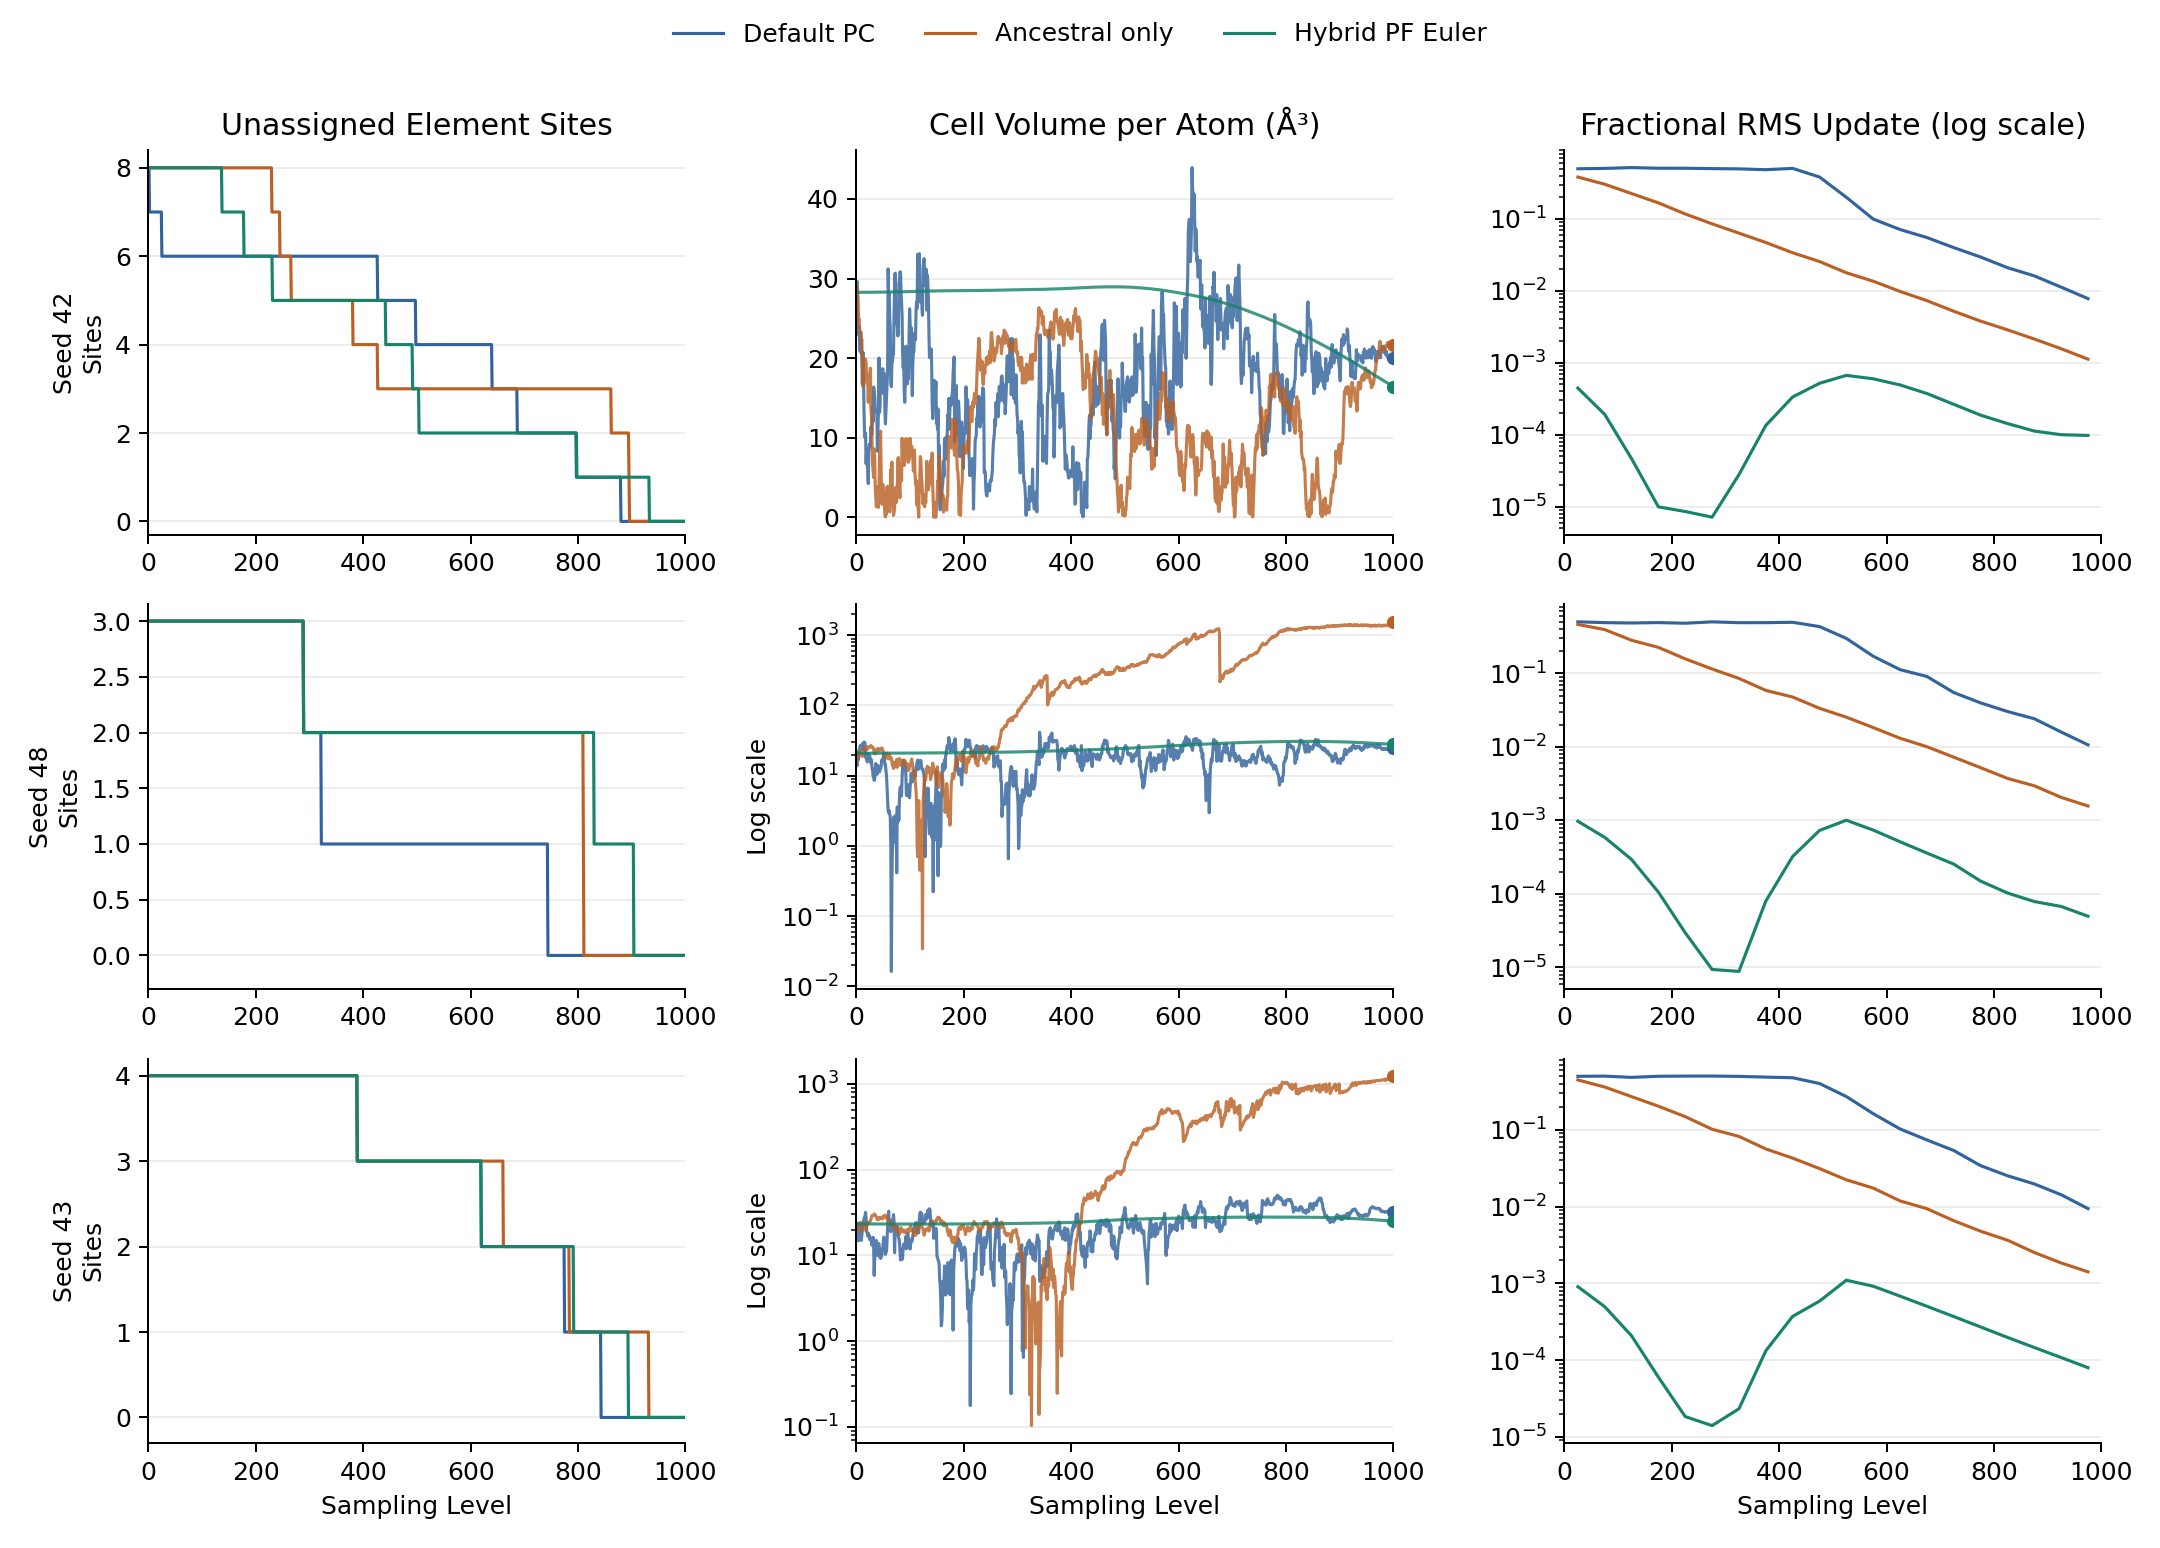
| 方法 | 网络调用/晶胞 | 三样本采样耗时中位数 | 各样本平均 的跨 seed 中位数 | seed 42 / 48 / 43 的最终体积(ų/站点) |
|---|---|---|---|---|
| PC | 2,000 | 66.62 s | 0.28076 | 20.03 / 24.81 / 32.30 |
| 仅祖先预测 | 1,000 | 31.04 s | 0.09136 | 21.62 / 1,550.08 / 1,233.09 |
| 混合概率流 Euler | 1,000 | 30.47 s | 0.000324 | 16.39 / 27.83 / 25.08 |
三个初态下,每种方法都生成了与本组另外两种方法不同的最终元素组成。以 seed 48 为例,PC、仅祖先预测、混合 Euler 的组成依次为 NdDyC、Rb₂Se、NdDyGa。仅祖先预测给出了非常拉长而歪斜的晶胞,三边约 185–190 Å,原生晶格矩阵条件数为 159,体积 1,550.08 ų/站点。同一初态下另两种方法均低于 28 ų/站点。这个案例可直接指向需要下游检验的几何异常;对照中缺少能量、声子和独立稳定性标签,不能据此给三种方法排物理质量名次。逐样本全指标 · 异常端点 CIF · 对应 PC 端点
相同 1,000 次网络调用下,两种方法的时延接近,轨迹形状却有显著数量级差别。混合 Euler 的平滑性也可以与净位移交叉检查。seed 42、48、43 的起点到终点分数坐标 RMS 分别为 0.183、0.235、0.266,其每原子体积从 28.26、20.84、23.27 变为 16.39、27.83、25.08 ų。许多小步累积产生了可测量的净变化。PC 的大步则包含主动注入的噪声,不能把一步步长直接解释为算法误差。三个种子的配对轨迹图 · 全部公式、输入与复现步骤
6.4 固定采样器,只改变噪声起点
再用 base 权重比较三个等大的初态。每个初态有 8 个 MASK 位点,使用同一空性质条件。只重抽 (种子 142、143、148),每次反向求解前把连续随机种子与元素随机种子分别重置为 10042 和 20042。原三组实验从尺寸分布抽样,此处显式固定 。因此可以在同一求解器下,观察初始几何对同一次采样程序的影响。
默认 PC 的三个终态依次是 LiTl₅Sn₂、Sm₂Cu₂Si₄、Li₂Pb₆,体积分别为 28.25、17.61、28.36 ų/位点。第一和第三种的平均体积很接近,晶胞内的元素集合与计数却不同。三条路径都将全部 MASK 揭示,首次达到全已知的噪声级分别为 879、919、838。三种求解器都在每个先验上完整运行,所以同一组九条轨迹可以纵向比较起点、横向比较更新规则。此实验给出三个具体起点的变化范围;估计候选分布及采样概率需要更多独立试验。逐样本组成与路径指标 · 三乘三对照、验证与复现
6.5 固定化学条件,换一个种子还能生成什么?
第 7 节还可以选定 Mg–O 或 Al–O,再固定 或 。这四组都使用同一化学条件权重、默认 PC 和 1,000 个噪声级。在每组里,种子 42 抽到 8 个位点,43 抽到 4 个位点。每条轨迹有 2,000 条存档,页面对齐其中 9 个时刻并单独显示最终结构。例如,固定 Mg–O 与 时,两次得到 Mg₄O₄ 与 Mg₂O₂,均为 1∶1;固定 Mg–O 与 时,两次得到 Mg₃O₅ 与 Mg₂O₂,元素集合仍相同,配比已不同。这个比较同时允许位点数、初始几何和后续采样随机数随种子变化。四组数据与下一节的 CFG 实验共用相应原始运行。四组同步快照的生成代码(课程仓库,需权限) · 逐样本结果
7 固定了目标,怎样调整它对同一步更新的影响?
7.1 CFG 在三个输出上做了什么?
对同一 和同一份条件权重,记不使用条件嵌入的输出为 ,使用目标 的输出为 。官方实现将其组合成 。 直接采用无条件分支, 采用条件分支, 沿差值方向线性外推。对连续字段这一步组合 score,对类别组合 logits,再用 D3PM 后验抽样。若 ,在适用的类别支持上归一化即得到 。离散字段混合发生在后验更新之前。由于位置、晶格和元素共享上下文,一次 CFG 干预可能同时改变元素选择与后续几何。guidance_scale 使用上述具体约定,其他项目把“外推增量”另记一个参数时应先换算。CFG 原论文 · 本版混合与端点分支
三种可以分别干预的量至此都已出现。换条件 改变交给模型的信息;调 改变条件与无条件输出的组合;换求解器 改变给定输出如何更新状态。化学集合实验只改变前两项,固定默认 PC。空间群使用另一份适配权重,跨权重的输出不用于估计单一条件强度效应。
7.2 给出元素集合后,会出现哪些元素,各有几个?
在 GPU 4 上用同一冻结 chemical_system 权重运行 12 次推理。每个 seed 在两个目标、三档强度间核对完整第一条保存结构一致。判定“精确命中”的标准为输出元素集合与请求集合相等。公式下标是提交晶胞内的实际位点计数,未做最简比约化。
| 目标 | seed / 位点数 | γ=0 | γ=1 | γ=2 |
|---|---|---|---|---|
| Mg–O | 42 / 8 | F₆InMg | Mg₄O₄ | Mg₃O₅ |
| Al–O | 42 / 8 | F₆InNi | Al₂O₆ | Al₃O₅ |
| Mg–O | 43 / 4 | AuBiLiLu | Mg₂O₂ | Mg₂O₂ |
| Al–O | 43 / 4 | AuBiLiLu | AlO₃ | Al₂O₂ |
| 合计命中 | 4 项 | 0/4 | 4/4 | 4/4 |
固定 seed 42 和 γ=1,改换目标由 Mg₄O₄ 变为 Al₂O₆。固定 Mg–O 和同一初态,增加 γ 又把氧比例从 4/8 改为 5/8。两种非零强度在四项案例中都已命中,提高强度没有带来额外的集合命中。seed 43 的两个强度还有相同计量的例子,具体输出并非普遍单调。γ=0 的两个实验名称各对应一次无条件分支调用;seed 42 两次关闭条件却有不同终态,体现 GPU 数值差异可随采样放大,不能把这个差别归因于条件标签。12 次运行的首末墙钟跨度约 12 分 02 秒,两个进程共享同一张卡,单进程端到端为 110.0–129.5 秒。原始结果表 · 完整原件、状态与哈希(课程仓库,需权限)
补齐七档以后。 保留原来的三档,在同一 chemical_system 权重与 PC 配置下新增 16 次推理。两个种子各自跨 14 次运行的首帧均通过同一哈希检查。下表每列有两个目标 × 两个种子。最小非零档有一个容易误解的结果,见第一行。GPU 2 的新批次与 GPU 4 的原三档采用相同型号 RTX A6000;执行时的并发数不同,计时单独保留。
| 对照 | 0 | 0.25 | 0.5 | 1 | 1.5 | 2 | 3 |
|---|---|---|---|---|---|---|---|
| Mg–O,seed 42 | F₆InMg | Mg₈ | Mg₄O₄ | Mg₄O₄ | Mg₄O₄ | Mg₃O₅ | Mg₄O₄ |
| Mg–O,seed 43 | AuBiLiLu | Mg₃O | Mg₂O₂ | Mg₂O₂ | MgO₃ | Mg₂O₂ | Mg₂O₂ |
| Al–O,seed 42 | F₆InNi | Al₂O₆ | Al₃O₅ | Al₂O₆ | Al₃O₅ | Al₃O₅ | Al₄O₄ |
| Al–O,seed 43 | AuBiLiLu | Al₂O₂ | Al₂O₂ | AlO₃ | Al₂O₂ | Al₂O₂ | Al₂O₂ |
| 精确集合命中 | 0/4 | 3/4 | 4/4 | 4/4 | 4/4 | 4/4 | 4/4 |
Mg₈ 的每个位点都在 Mg–O 白名单内,整份晶胞仍缺氧,因而集合检验失败。把 提到 0.5,同一初态得到 Mg₄O₄。继续提到 2、3,氧的位点比例依次为 5/8、4/8;集合命中可以持平,化学计量仍会变动。观察到的平台只有两个独立种子,不能据此选出普适引导系数。同为 Mg₄O₄ 的结果也可能体积不同,例如 0.5 与 1 的终态分别约 9.7 与 12.9 ų/位点。28 个结果与所有指标 · 七档原始归档(课程仓库,需权限)
7.3 命中是网络学到了条件,还是程序筛掉了元素?
为观察目标专用元素屏蔽的作用,另做四个配对推理。固定 Mg–O、相同种子、相同权重、PC 与 ,仅在官方支持元素的全局筛选后绕过目标集合专用 logit 屏蔽。学习到的 Mg–O 条件嵌入照常送入网络。验证时记录分支启用状态,并检测一个集合外 Si 类别的 logit 在该额外筛选点前后逐值一致。
| seed | γ | 原配置 | 移除目标专用屏蔽 |
|---|---|---|---|
| 42 | 1 | Mg₄O₄ | Mg₅O₃ |
| 42 | 2 | Mg₃O₅ | Mg₄O₄ |
| 43 | 1 | Mg₂O₂ | Mg₂O₂ |
| 43 | 2 | Mg₂O₂ | MgO₃ |
在这四个样本上,保留嵌入、引导和全局元素约束就能命中目标,两档各 2/2。与完整配置比较,四例中三例的氧位点比例发生变化。实验仅覆盖 Mg–O、两个种子;它支持本条件中学习信号能够参与选择,尚不足以估计程序筛选对整个化学空间的边际贡献。四次附加推理墙钟跨度约 3 分 48 秒。干预实现(课程仓库,需权限) · 消融结果 · 干预日志与全部轨迹(课程仓库,需权限)
七档官方实验和消融合计 32 个独立终态,均通过 CIF 与最终 EXTXYZ 周期等价检查。在 64,000 个保存的中间记录中,主实验的两条有零体积晶格,来自 seed 43、Mg–O、γ=0 的原始索引 396 和 γ=2 的索引 893。原始档案保留全部记录。三维预览从可用记录抽取,并保留原始索引。出现退化中间表示与最终 CIF 的完整性分别检查。主实验检查摘要(课程仓库,需权限) · 消融检查摘要(课程仓库,需权限) · 完整分析
7.4 要求涉及空间排列时,怎样验证条件响应?
将性质从“出现哪几种元素”换成“完整晶体具有哪种空间群”。在同一冻结 space_group 权重下,以 batch seed 20261118 取四份初态,得到 8、4、10、20 个站点。各跑三个分支:无引导参考、以 γ=2 请求第 1 号 P1、以 γ=2 请求第 225 号 。参考批的参数中有目标 1,但 γ=0 只调用无条件分支,这批可作为两个目标的共同参照。从未弛豫的最终 CIF 提取晶格、分数坐标和元素,送入 spglib;同时对独立最终 EXTXYZ 做同一检测。代码使用 spglib 2.7.0,角度容差 5°,主距离容差 0.05 Å,另做 0.01 和 0.10 Å 扫描。检查依据是导出的实际几何。两种文件的检测结果一致。数据、设备与调用参数(课程仓库,需权限) · 生成与对称性分析(课程仓库,需权限)
| 同一初态 | 位点数 | 无引导测得的群 | 请求 #1 测得的群 | 请求 #225 测得的群 |
|---|---|---|---|---|
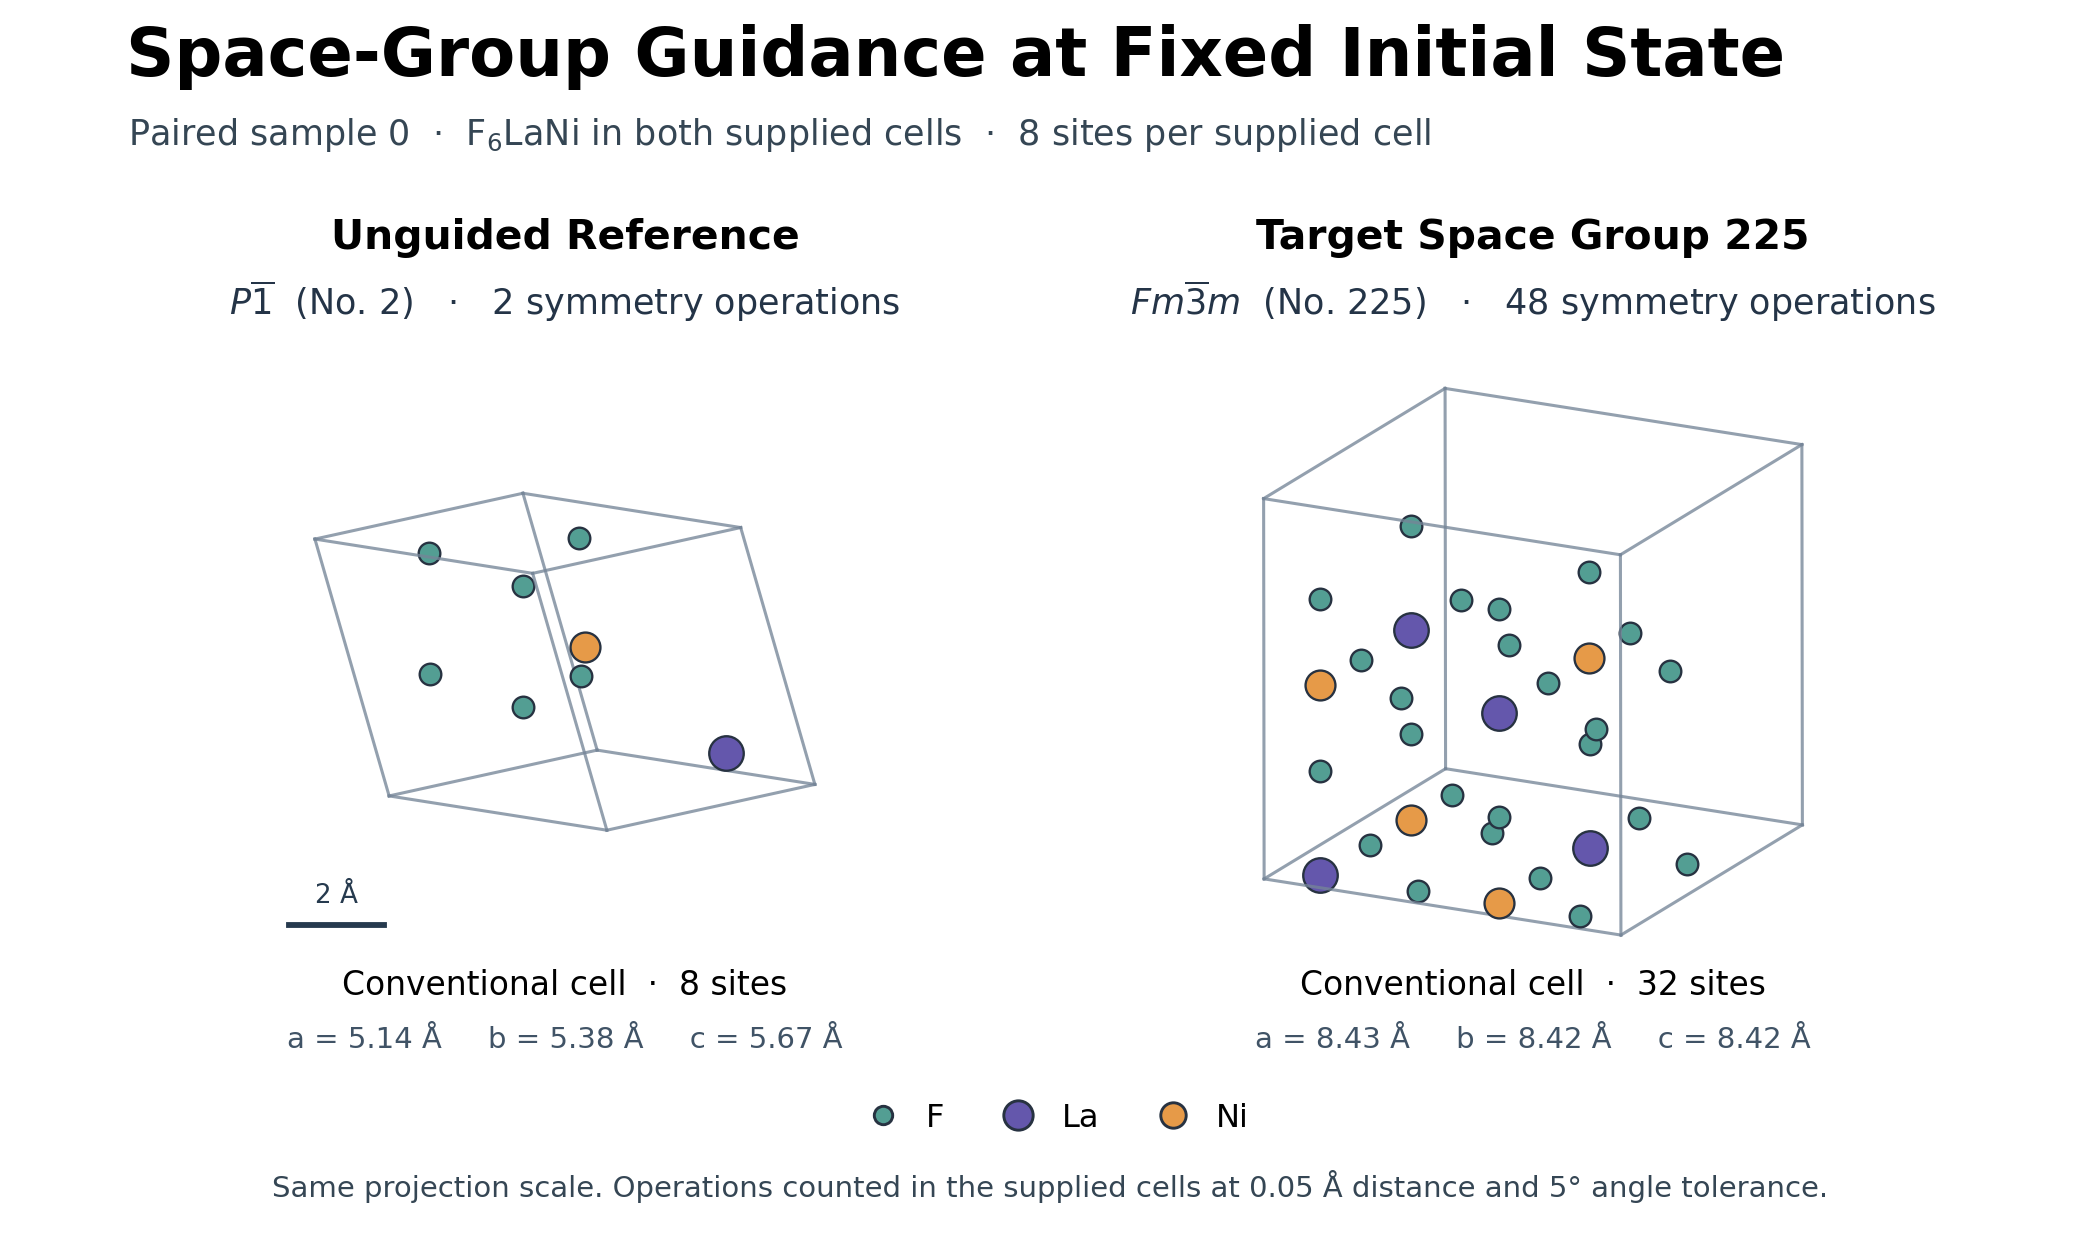
| 0 | 8 | 2 | 1 | 225 |
| 1 | 4 | 160 | 2 | 225 |
| 2 | 10 | 44 | 1 | 225 |
| 3 | 20 | 1 | 1 | 74 |
两个目标各精确命中 3/4。共同参考的 #1 与 #225 各为 1/4 和 0/4。样本 0 在参考和 #225 两个分支中恰好同为 F₆LaNi,分别测得 #2 和 #225;在各自提供的输入晶胞中,spglib 找到 2 与 48 个对称操作。这个例子能把“组成相同”和“几何对称性不同”直接呈现在两份真实文件上。插图若采用常规晶胞,可能含有更多周期等价站点,操作数应按上文的输入胞解读。这一对同时改变了是否启用条件与引导强度;独立估计单独一项的作用需要额外分支。参考 CIF · 目标 225 CIF · 等比例结构图
样本 3 请求 #225 后,按 0.05 Å 判为 #74,严格到 0.01 Å 判为 #8;两个结果均未达到所请求的群。三档容差下两个目标各自的总命中数都为 3/4。四个配对实例能同时展示成功和偏差,但总体命中率仍有很大抽样不确定性。三批的进程端到端耗时为 85.5、119.5、115.7 秒,每批含四个晶体。这些时间和第 6 节单样本的纯采样时段有不同测量口径。逐容差逐样本表 · 原始运行档案(课程仓库,需权限) · 空间群实验详情
结论怎样交给物理验证?
现在可以围绕同一个候选连续回答三类问题。它是怎么来的? 看 checkpoint、条件、噪声与求解器、第一条记录、独立 final。它实现了哪些目标? 从最终 CIF 重算元素集合、尺寸与对称性,并附具体阈值。它能否作为材料存在? 需要与所声称的物理性质匹配的进一步检验,例如弛豫前后几何与残余力、相对于参考相的能量、对小位移的动力学响应。提交给物理组时保存输入 CIF 哈希,为弛豫后的输出另设 ID,用明确的对照将数据完整性、条件响应、物理判断串起来。这里的能量与声子仍是下游要回答的问题。交接字段(课程仓库,需权限) · 基础候选的物理验证记录状态
附录 A 怎样复核站点重排与平移探针?
在 members/tk/ 目录、已准备好本地 base 权重的 MatterGen 环境中运行下列 Python。它检验一次前向。项目中的三个返回字段沿用输入字段名称,其中 atomic_numbers 在输出一侧已变为 logits。比较重排前后的结果时,先对参考输出施加相同置换,再逐项求误差。平移只作用于坐标,因此保持参考输出原顺序。这一带噪样本恰好仍显示三个元素标签;第 5 节的掩码概率描述的是随机边际。探针全部输入、三个输出和精确误差 · 运行环境准备(课程仓库,需权限)
from pathlib import Path

import torch
from pymatgen.io.cif import CifParser
from mattergen.common.data.collate import collate
from mattergen.common.data.dataset import CrystalDataset, structures_to_numpy
from mattergen.common.data.transform import set_chemical_system_string, symmetrize_lattice
from mattergen.common.utils.data_classes import MatterGenCheckpointInfo
from mattergen.common.utils.eval_utils import load_model_diffusion

torch.set_num_threads(1)
cif = Path("deliverables/tk-cuda-seed48/final.cif")
weights = Path("external/models/checkpoints/mattergen_base").resolve()

with torch.inference_mode():
    structure = CifParser(cif).parse_structures(primitive=True)[0]
    structure.properties["material_id"] = "tk-cuda-seed48"
    arrays, properties = structures_to_numpy([structure])
    dataset = CrystalDataset(
        **arrays, properties=properties,
        transforms=[symmetrize_lattice, set_chemical_system_string],
    )
    graph = collate([dataset[0]])
    loaded = load_model_diffusion(MatterGenCheckpointInfo(model_path=weights)).cpu().eval()
    diffusion = loaded.diffusion_module
    torch.manual_seed(17)
    time = torch.tensor([0.4])
    noisy = diffusion.corruption.sample_marginal(graph, time)
    reference = diffusion.model(noisy, time)

    perm = torch.tensor([2, 0, 1])
    reordered = noisy.replace(pos=noisy.pos[perm], atomic_numbers=noisy.atomic_numbers[perm])
    translated = noisy.replace(pos=(noisy.pos + torch.tensor([0.25, 0.375, 0.625])) % 1)
    for name, variant, order in [
        ("permutation", reordered, perm),
        ("translation", translated, torch.arange(3)),
    ]:
        observed = diffusion.model(variant, time)
        for field in ("atomic_numbers", "pos", "cell"):
            expected = getattr(reference, field)
            if field != "cell":
                expected = expected[order]
            print(name, field, (getattr(observed, field) - expected).abs().max().item())
该输入 CIF 来自 CUDA 基础库 seed 48,生成初态和 CPU 探针的加噪初态有各自的种子与用途。探针使用单线程 CPU、FP32、Python 3.10.21、PyTorch 2.4.1、PyG 2.8.1、pymatgen 2024.10.29;其余环境、张量形状和带噪字段保存在 JSON。单纯检验本手册的数值表时,读出三套已保存的输出即可独立重算每个最大绝对差。
附录 B 从一个结果追到原始文件
选择样本。 在 experiment_index.csv 用实验、seed、批位置以及条件选择一行。基础库候选的唯一标识如 tk-cuda-seed48。条件实验中,seed 43 的不同目标或强度有各自的端点;空间群样本还要带批内位置。表中的 sites、formula、volume_per_site_A3 是最终结构属性,raw_records 指该轨迹实际写出的记录数。time_scope 给出计时归属,尤其要留意“一整个 batch 耗时”和“单个样本纯采样耗时”。initial_sha256 可用时描述该协议登记的初态;基础库未登记这项哈希的行留空。逐终态索引
读出原件。 final_cif、raw_trajectory、run_record 与 config 的相对路径自 members/tk/ 起算。! 表示进入前一层 ZIP,例如化学实验先打开 source_data.zip,再打开内部的 generated_trajectories.zip,最后取 gen_0.extxyz。基础库及条件实验的轨迹包含晶格、站点和分数坐标可恢复的笛卡尔坐标。配对求解器保留 NPZ 中的原生分数张量和晶格矩阵,便于比较相同噪声级和相同站点。批量比较先用 CSV;核验具体一行时回到实际最终 CIF、原始轨迹和版本记录。采样器实例(课程仓库,需权限) · 来源包与哈希(课程仓库,需权限)
固定实现。 三份权重来自同一官方模型库 revision 5244495dd9a979ff71abc7548a0b14b9deb0069a;MatterGen 代码固定为 92423660a8bd70e83679086e88f88596d484dc16。以下 SHA-256 按完整权重文件计算。运行档案另存配置与 Git LFS 指针,便于取得相应版本并对照。权重和代码身份一致,跨设备浮点归约、并行库和随机流实现仍可能影响逐样本完全复现。冻结版本、采样配置与日志(课程仓库,需权限) · 基础库推理和校验步骤(课程仓库,需权限)
| 权重 | 对应实验 | 权重文件 SHA-256 |
|---|---|---|
mattergen_base |
基础无条件、配对求解器、CPU 前向探针 | 81668ee12afc1ee1b037f362420730de3460bfd2d36e547585fdcb911a3dfdef |
chemical_system |
化学体系、CFG、移除目标专用屏蔽 | 4ad21d977c2b776a31c92498c4d1c88d3e1e286deeb941e997af8e082310b80e |
space_group |
空间群条件 | 1b6ab06739f4319d75f4a19960840ec3c8d3d32ee842c996876ef9d8b188e4bb |
下面的例子仅需 Python 标准库。它从索引选取 seed 42、化学体系 Mg–O、γ=1,验证外层原始档案的 SHA-256,再从嵌套 ZIP 取出独立终态的 CIF。对一般表项也适用同一文件寻址方法。
import csv
import hashlib
import io
import json
import zipfile
from pathlib import Path

with Path("analysis/experiment_index.csv").open() as file:
    rows = list(csv.DictReader(file))
row = next(r for r in rows if r["experiment"] == "chemical_system"
           and r["seed"] == "42" and r["condition"] == "Mg-O" and float(r["gamma"]) == 1)
archive, *members = row["final_cif"].split("!")
payload = Path(archive).read_bytes()
hashes = json.loads(Path("analysis/evidence_sha256.json").read_text())
assert hashlib.sha256(payload).hexdigest() == hashes[archive]
for member in members:
    with zipfile.ZipFile(io.BytesIO(payload)) as handle:
        payload = handle.read(member)
print(row["formula"], row["sites"], payload.decode().splitlines()[:4])
完整重跑时按对应实验文档中的命令建立新输出目录。结构工具处理的问题各不相同:能读出 CIF 可以核查导出过程;元素集合、氧比例和空间群可以核查设计要求;MLIP/DFT 弛豫、相稳定性与声子计算才为相应物理主张提供后续证据。并列保存这些问题的输入和度量,可以让物理组在同一候选上接续验证。配对求解器 · 化学体系和干预 · 空间群复现 · 基础样本分析